새 표적을 정하면, 연구보다 먼저 해야 하는 일이 있습니다. 데이터를 찾고, 모으고, 분석할 수 있는 형태로 맞추는 일입니다.
연구자에게는 이런 문제가 있었습니다
데이터베이스가 너무 많고 계속 바뀝니다. Nucleic Acids Research의 분자생물학 데이터베이스 목록은 2026년 1월 기준 2,173개입니다. 지난 한 해 동안 새로 96개가 추가됐고, 주소가 사라진 319개가 목록에서 빠졌습니다.
크고, 형식이 제각각입니다. MGnify 단백질 표는 1.11TB(서열 57억 개 이상)이고, UniProt TrEMBL은 gzip FASTA만 40.6GB입니다. 내려받아 풀고 색인하는 동안 연구는 멈춰 있고, 같은 준비를 연구자마다 되풀이합니다.
DB 하나만 조회하면 다른 층의 근거를 놓칩니다. 유전자 하나의 발현, 의존성, 결합 측정, 변이, 상호작용은 서로 다른 기관의 서로 다른 데이터베이스에 있습니다.
식별자가 어긋난 join은 조용히 틀립니다. UniProt accession, Ensembl ID, HGNC symbol, PubChem CID처럼 식별자 체계가 다른 표를 join하면, 매칭되지 않은 행은 오류 없이 사라집니다. 결과 표는 완성된 것처럼 보입니다.
그래서 AI3 Discovery가 BioQ를 만들었습니다
AI3 Discovery도 연구하면서 같은 준비를 직접 겪었습니다. 그래서 그 일을 연구자 대신 먼저 했고, 그 결과가 BioQ입니다. 공개 바이오 데이터베이스 97종을 원본과 대조해 적재하고, 바로 질의할 수 있게 색인하고, 식별자 기준으로 레코드를 교차 연결했습니다. 데이터는 우리가 모았으니, 연구자는 질문만 가져오시면 됩니다.
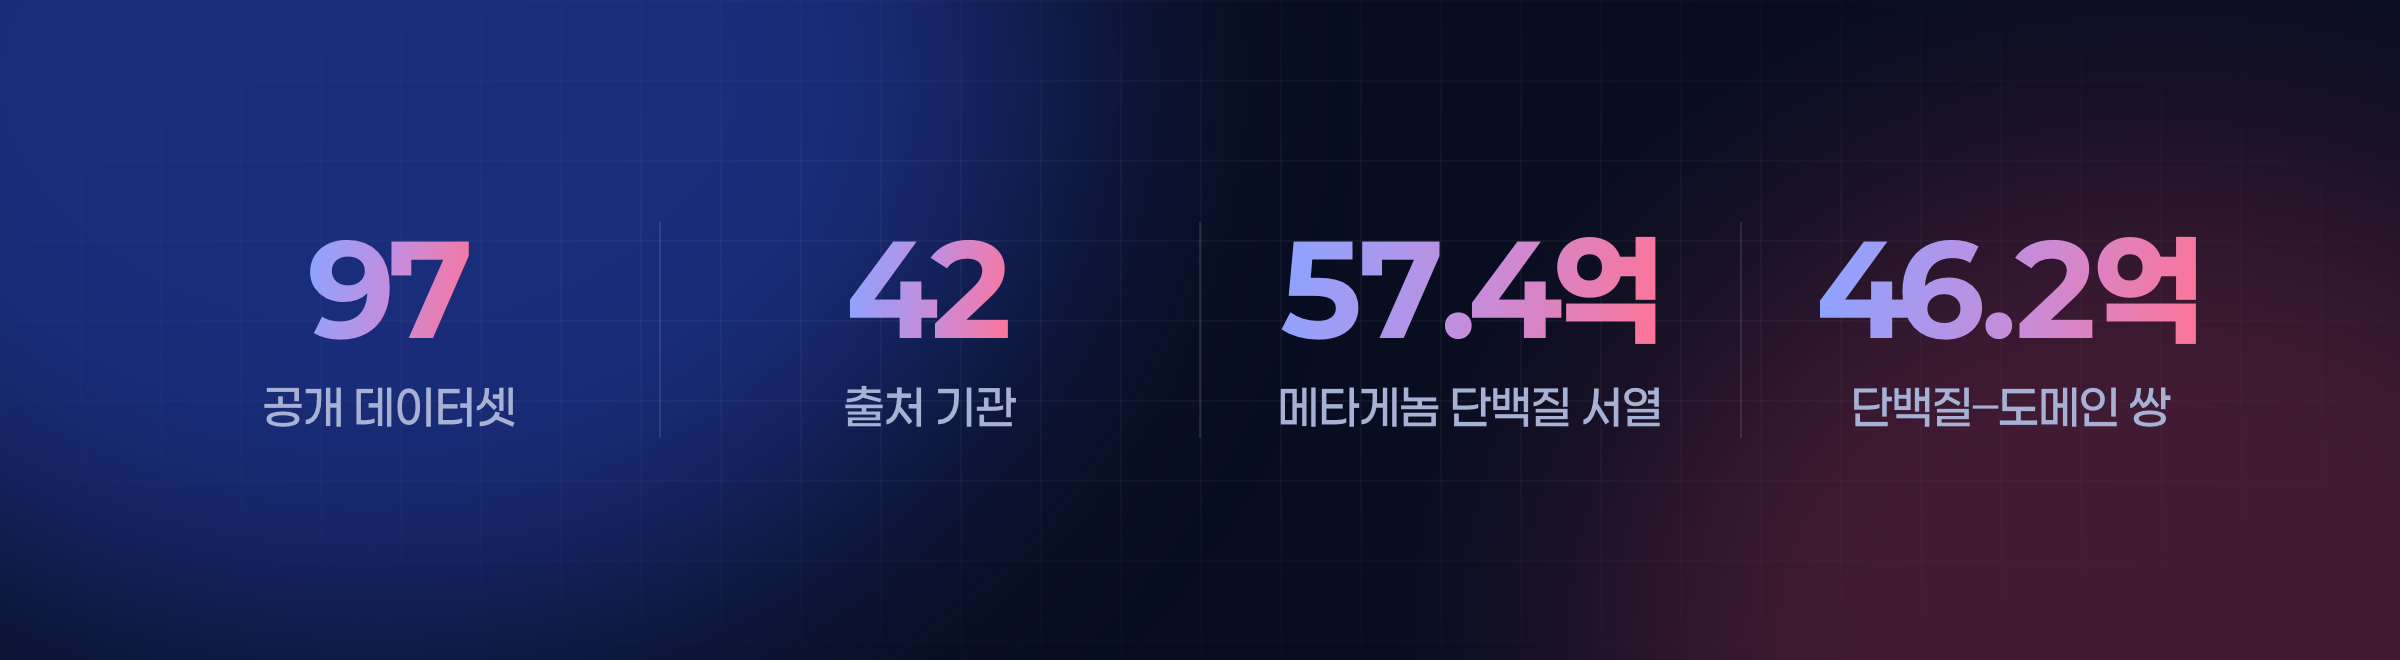
UniProt, PDB, AlphaFold DB, ChEMBL, ClinVar, STRING, DepMap, GTEx, Human Protein Atlas까지. 연구에 쓰는 공개 데이터 97종을 하나씩 내려받을 필요도, 식별자를 손으로 맞출 필요도 없습니다. 전체 목록과 출처는 데이터 카탈로그에 있습니다.
평소 쓰는 말로 묻습니다
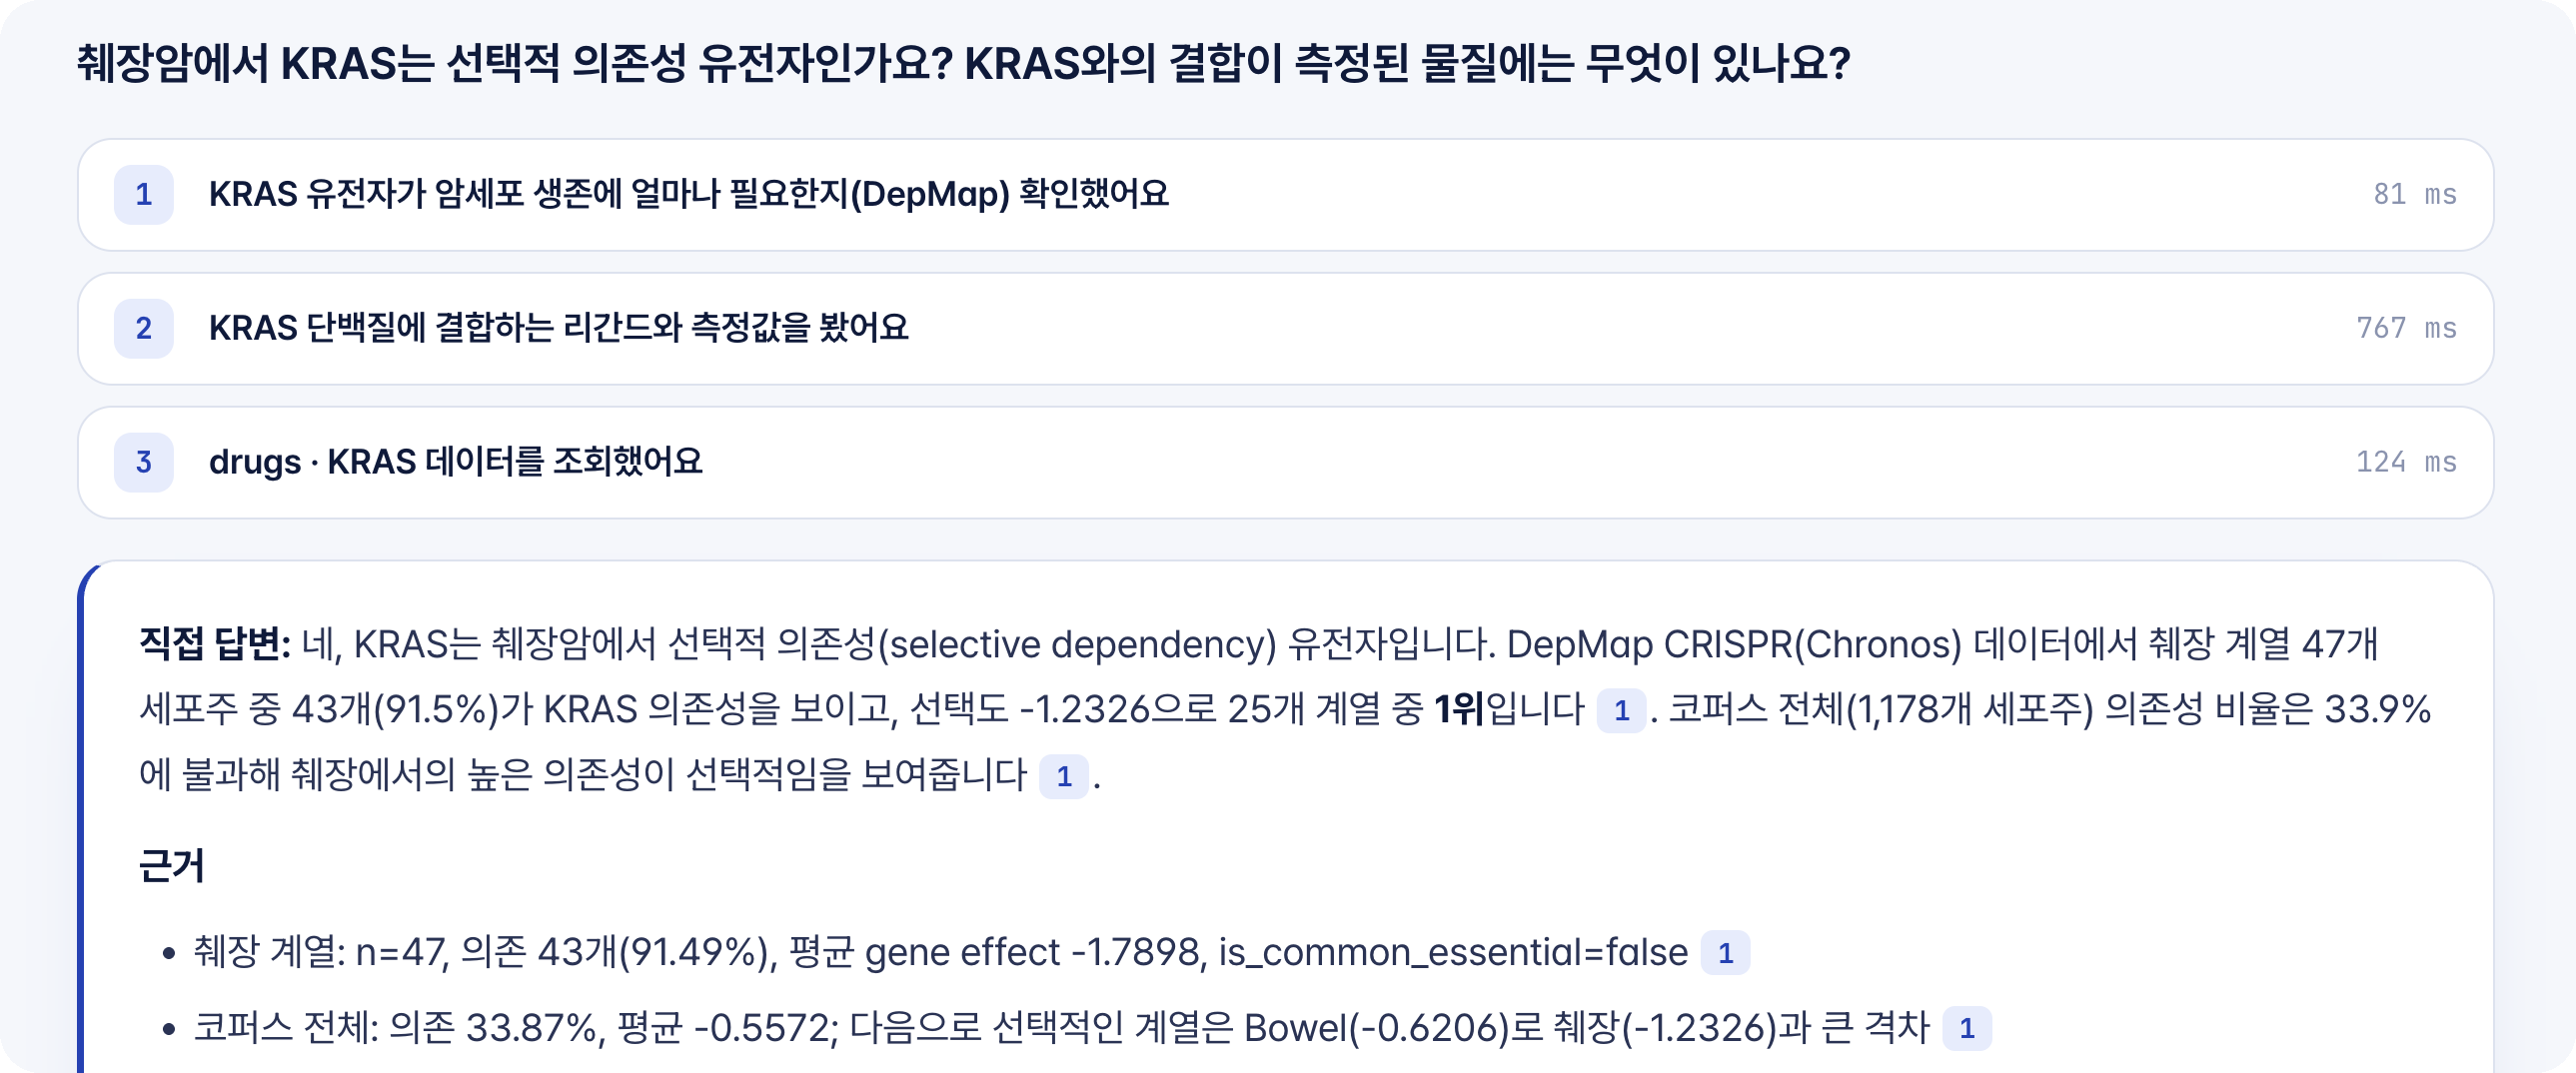
그림 1. 질문 하나, 출처가 붙은 답. 췌장 계열은 KRAS 의존성 선택도 −1.2326으로 25개 계열 중 1위이고(43/47 세포주), 전체 1,178개 세포주의 의존 비율은 33.9%입니다.
질문하면 에이전트가 필요한 레이어를 골라 한 번에 조회하고, 수치마다 레코드 출처(citation)를 붙입니다. 답의 한계(limits)도 같이 적습니다. 어떤 연구에 어떻게 쓰는지, 다른 도구와 무엇이 다른지는 사용 사례에 정리돼 있습니다.
층을 겹쳐 봅니다
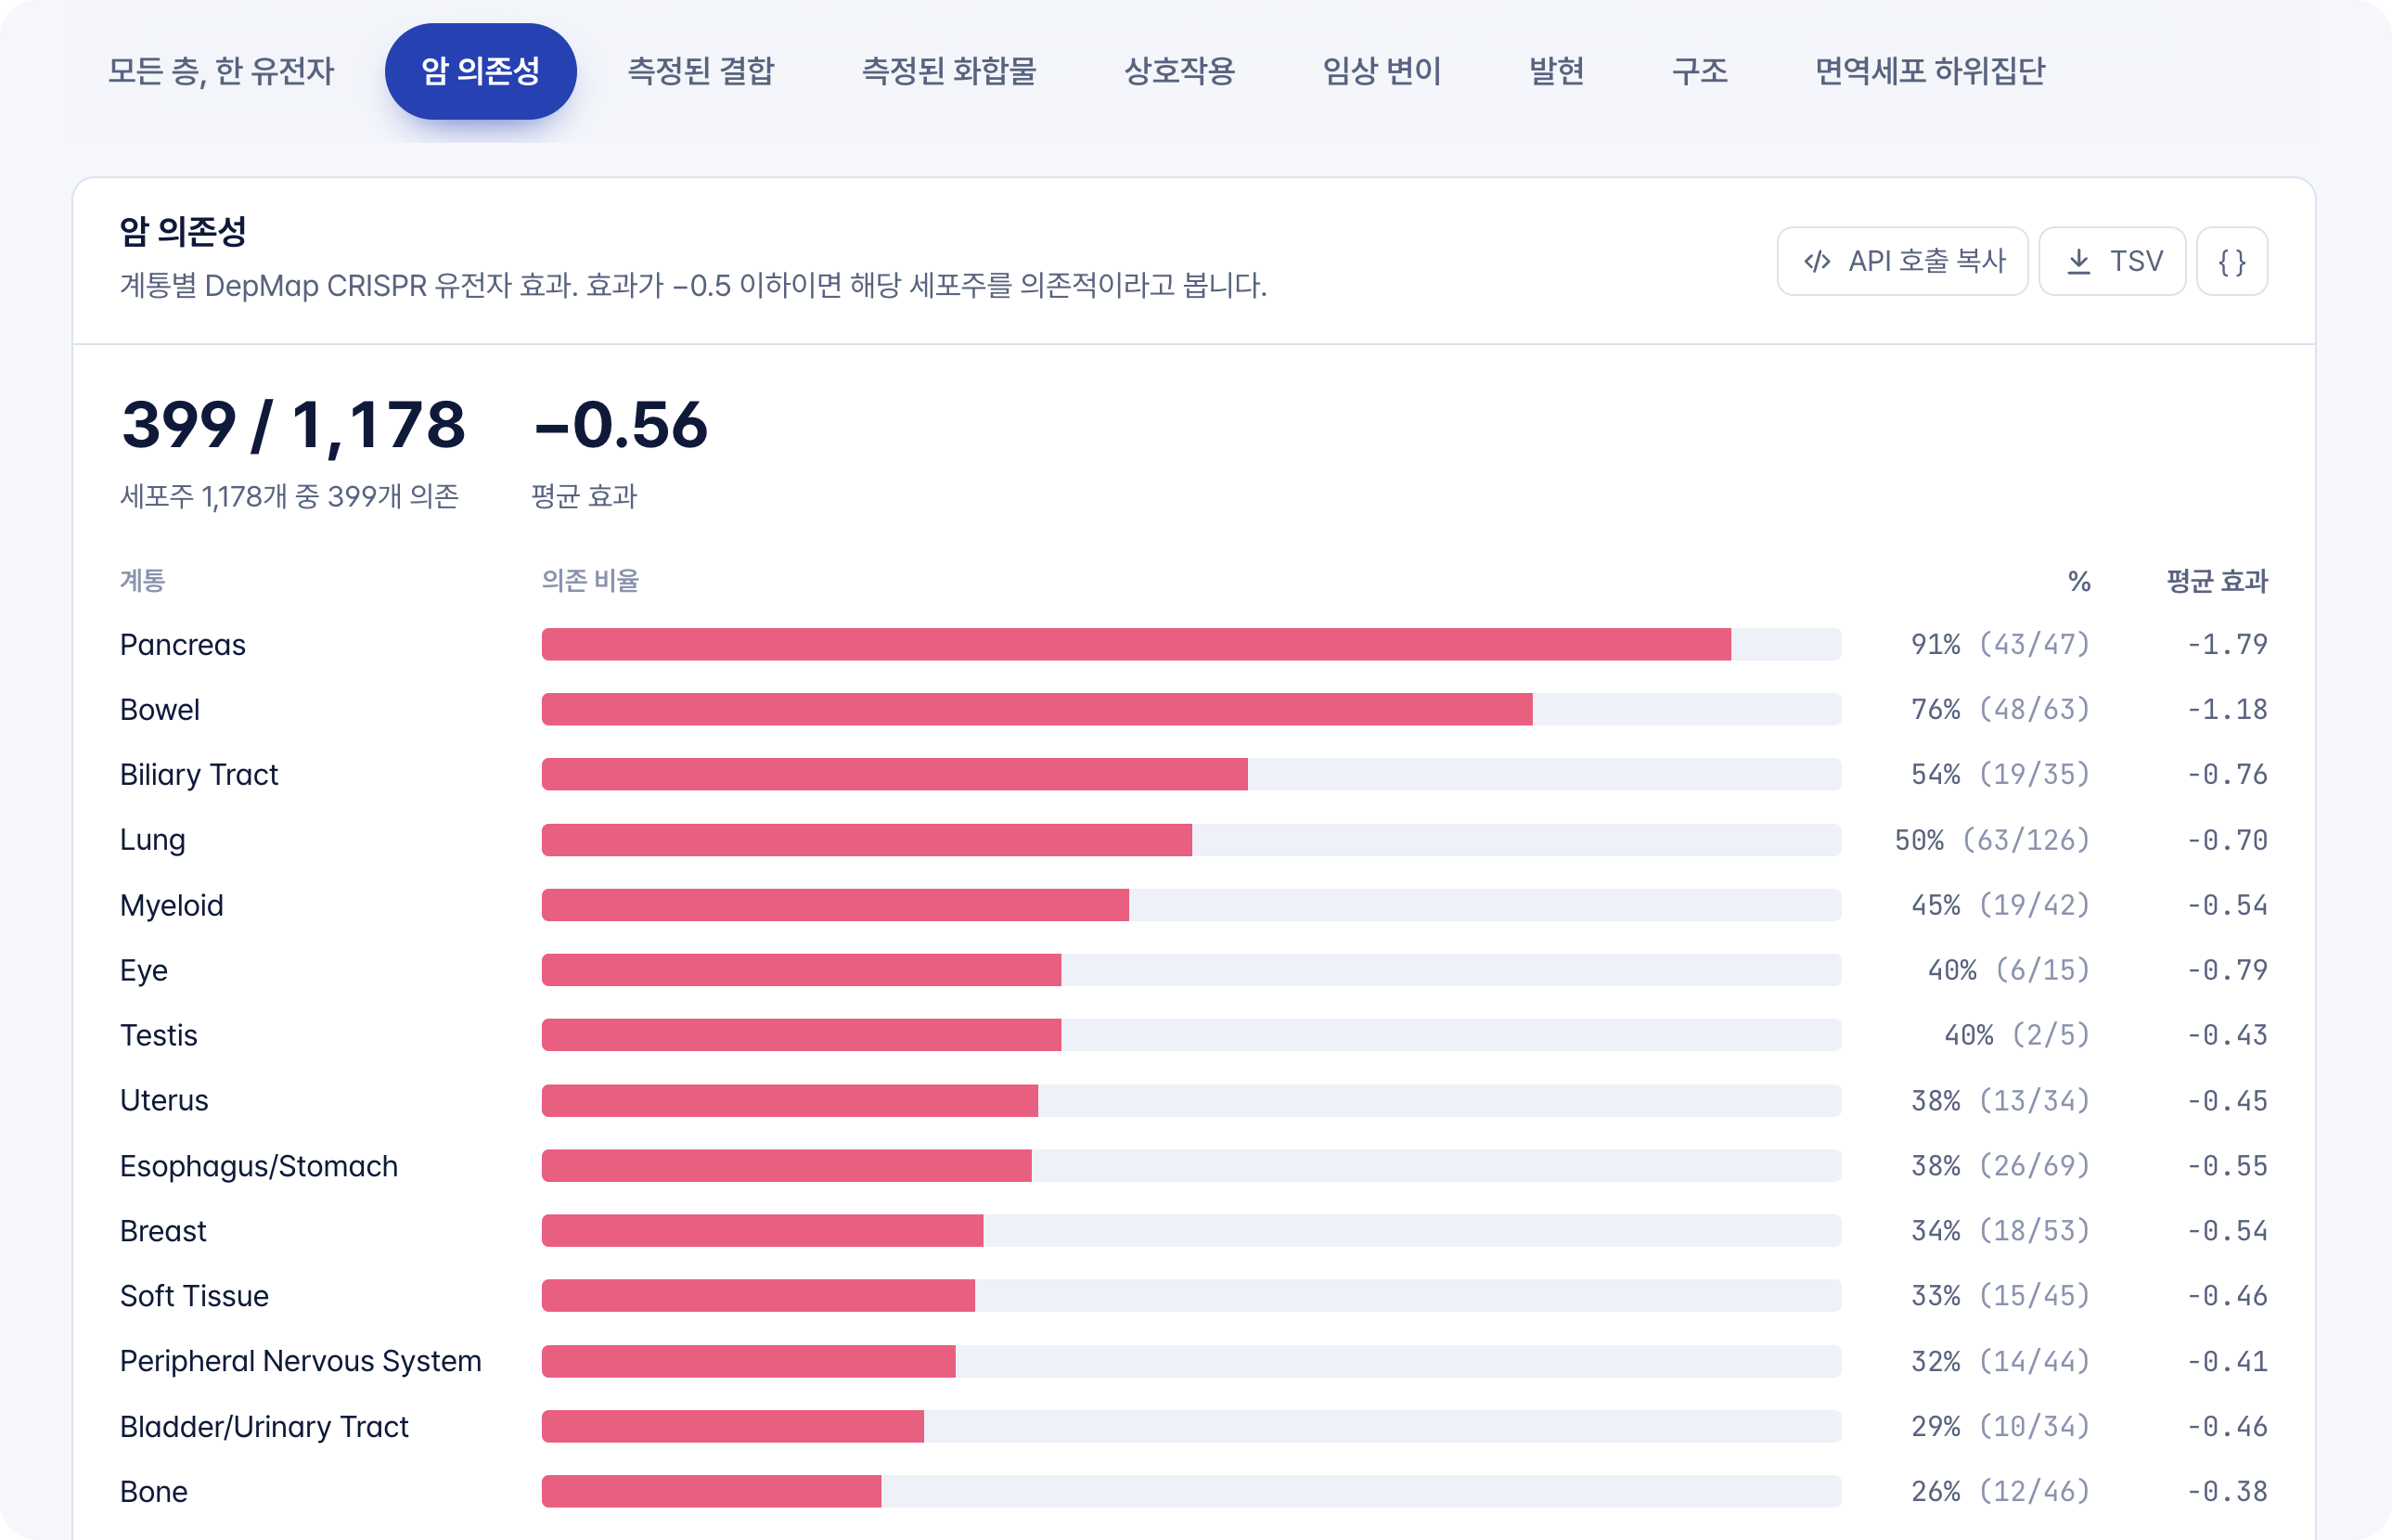
그림 2. KRAS의 계통별 암 의존성. 계통별로 의존하는 세포주의 비율입니다(DepMap CRISPR).
유전자 하나를 검색하면 암 의존성, 측정된 결합, 상호작용, 임상 변이, 발현, 구조, 면역세포 하위집단이 탭으로 이어집니다. UniProt accession을 넣으면 97개 레이어 가운데 그 accession을 받는 레이어가 한 번에 응답합니다. CD19(P15391)는 15개 레이어가 응답했고 12곳에서 레코드가 나왔습니다. 직접 하면 약 3.3시간(≈1.2TB 아카이브 확인)이 걸리는 질문이 BioQ에서는 0.33–0.37초입니다(직접 할 때와의 비교 6건, 공개 아카이브 전송 속도 기준이며 환경에 따라 다릅니다). 레이어별 가동 상태는 시스템 상태 페이지에서 볼 수 있습니다.
틀리지 않으려고
- 색인은 원본 레코드와 대조하고(총계 단언), 불일치하면 배포하지 않습니다.
- 배포마다 정답이 알려진 질의(known-answer test)로 스스로 점검하고, 하나라도 틀리면 서비스를 열지 않습니다.
- 응답 상태를 네 가지로 구분합니다. 있음(레코드를 다시 읽어 바이트까지 대조), 조회했으나 없음, 조회 불가(식별자 체계 불일치), 미확인. 미확인은 부재의 증거가 아닙니다.
- 붙여 넣은 서열은 AI 모델에 전달되지 않고(모델은 [SEQ1] 같은 placeholder만 받습니다), 대화 기록은 브라우저에만 저장됩니다(개인정보 처리방침).
오늘 바로 던져 볼 질문 세 가지
- 지금 연구 중인 단백질의 UniProt accession을 BioQ 검색창에 넣어 보세요. 몇 개 레이어가 그 단백질을 알고 있는지, 어느 레이어가 아직 조회하지 않았는지 한 번에 나옵니다. 비어 있는 곳이 다음 연구 질문일 수 있습니다.
- 가진 서열을 붙여 넣어 보세요. Swiss-Prot에서 E-value, percent identity와 함께 상동 단백질을 찾고, MGnify 대표 서열 1억 2,900만 개 가운데 exact match가 있는지도 확인합니다.
- 알려진 Pfam 도메인이 없는 큰 단백질 가족을 둘러보세요. 구성원 5개 이상이면서 Pfam 도메인이 하나도 없는 MGnify 클러스터가 5,890,193개입니다. biome과 크기로 걸러 볼 수 있습니다.
bioq.bio에서 이메일로 가입하면 카드도 승인 절차도 없이 바로 쓸 수 있고, 매달 무료 한도가 있습니다. Claude, ChatGPT, Cursor에는 MCP로 붙일 수 있고, 검색엔진의 모든 레이어를 API로도 호출할 수 있습니다.
데이터를 찾고 모으고 맞추는 일은 연구가 아니라 연구 앞의 준비입니다. 그 준비는 우리가 해 뒀습니다. 연구자는 연구에만 집중하세요.
수치는 BioQ 카탈로그(2026년 11월 15일 갱신)와 Nucleic Acids Research 2026 데이터베이스 특집호 편집 글(doi:10.1093/nar/gkaf1427) 기준입니다.